جامعة طيبة تختتم مؤتمر الذكاء الاصطناعي الدولي بنتائج بحثية في الطب واللغة والمخطوطات العربية
المدينة المنورة – إسراء الحرف
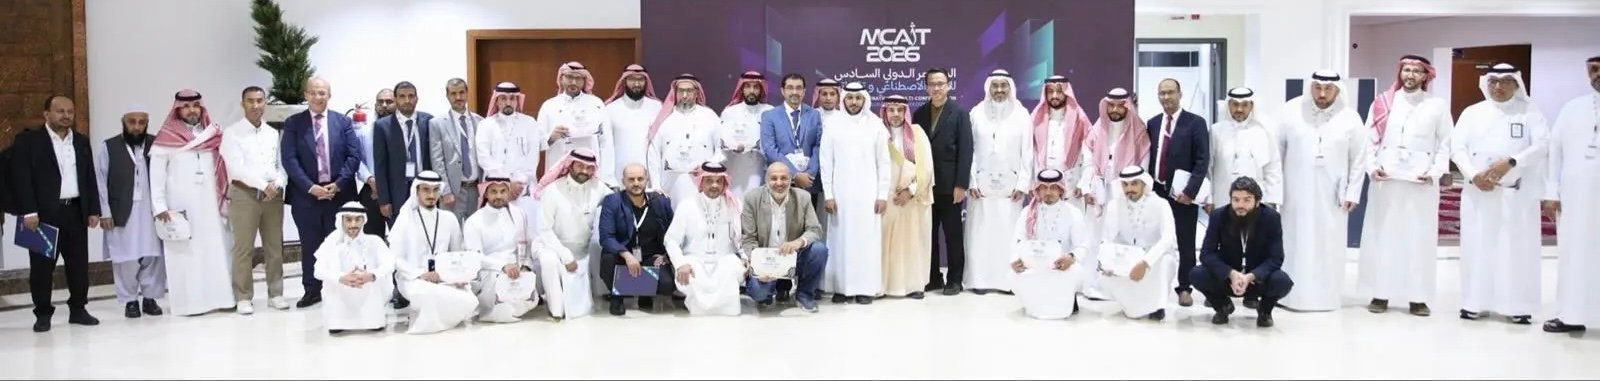
اختتمت جامعة طيبة بالمدينة المنورة أعمال المؤتمر الدولي السادس للذكاء الاصطناعي وتقنياته (MCAIT 2026)، بعد ثلاثة أيام من الجلسات العلمية والمحاضرات المتخصصة وورش العمل، التي ناقشت أحدث التطورات البحثية والتطبيقات العملية للذكاء الاصطناعي في عدد من المجالات الحيوية.
وشهد المؤتمر، الذي استضافته الجامعة بالشراكة مع الجامعة الوطنية الماليزية، مشاركة باحثين وأكاديميين وخبراء من 37 دولة، واستعراض 142 بحثًا علميًا مقبولًا من 98 جامعة، ضمن خمسة مسارات علمية شملت تقنيات الذكاء الاصطناعي المتقدمة وتطبيقاتها في مختلف القطاعات والأنظمة الذكية والأمن السيبراني والبيانات والمدن الذكية.
نماذج عربية تفهم حركة الشفاه
استعرض باحثون من جامعة طيبة نموذجًا يعتمد على تقنيات التعلم العميق للتعرف على أربع كلمات عربية من خلال تحليل حركة الشفاه دون الاعتماد على الصوت، محققًا دقة بلغت 87.02% في التجربة البحثية.
وشملت الكلمات التي اختبرها النموذج «نعم، لا، آسف، شكرًا»، فيما انخفضت الدقة إلى 78.01% عند إضافة فئة مخصصة لتمييز الكلمات غير المعروفة.
وتبرز هذه النتائج إمكانات تطوير تطبيقات مستقبلية للتواصل وفهم الكلام المرئي، مع التأكيد أن النتائج تخص النموذج والكلمات التي شملتها الدراسة، ولا تعني قدرته على قراءة الكلام العربي بصورة عامة.
تحليل 170 ألف سؤال طبي باللغة العربية
وفي مجال التطبيقات الصحية، عرضت الباحثتان إيناس الرحيلي وأريج الهذلي دراسة تناولت تصنيف نحو 170 ألف سؤال طبي باللغة العربية وفق ثلاثة مستويات للخطورة.
وحقق نموذج AraBERT نسبة بلغت 98.29% وفق مقياس F1 المستخدم في تقييم أداء نماذج التصنيف، مقارنة بنسبة 95.59% لنموذج CNN.
وتسلط الدراسة الضوء على فرص الاستفادة من تقنيات معالجة اللغة العربية في تطوير أنظمة مساندة لفرز الاستفسارات الصحية وتحديد أولويات التعامل معها، دون أن تكون هذه النماذج بديلًا عن التقييم الطبي المتخصص.
أبحاث تكشف تحديات فهم اللهجات العربية
وفي محور النماذج اللغوية، استعرضت الباحثة ريم التميمي تحليلًا شمل 17 دراسة علمية لقياس قدرة نماذج الذكاء الاصطناعي على فهم اللغة العربية الفصحى ولهجاتها المختلفة.
وكشفت النتائج تفاوت أداء النماذج في استيعاب اللهجات والمحافظة على المعنى والسياق الثقافي، الأمر الذي يعكس الحاجة إلى تطوير معايير تقييم أكثر شمولًا تراعي الخصائص اللغوية والثقافية للغة العربية.
وقدمت الدراسة إطارًا بحثيًا لتحسين تقييم كفاءة النماذج اللغوية وموثوقيتها، بما يدعم تطوير تطبيقات أكثر قدرة على التعامل مع التنوع اللغوي العربي.
الذكاء الاصطناعي في خدمة المخطوطات التاريخية
وتناولت دراسة قدمتها الباحثة بشاير الصيدلاني مقارنة بين تقنيات التعرف الآلي على النصوص العربية، من خلال تحليل 500 سطر من المخطوطات التاريخية.
وأظهرت المقارنة اختلافًا في أداء الأنظمة المستخدمة، إذ سجل أحدها معدل خطأ على مستوى الحروف بلغ 27.92%، مقابل 43.66% لنموذج آخر.
وفي تجربة مستقلة، حقق نموذج متخصص في استعادة التشكيل معدل خطأ بلغ 4.06%، بما يبرز أهمية اختيار التقنيات المناسبة لطبيعة النصوص التاريخية عند تنفيذ مشروعات الرقمنة والحفظ الرقمي.
اختبار موثوقية الإجابات القانونية بلغتين
وفي مجال التطبيقات القانونية، استعرضت الباحثتان نورة الراجح وميادة المصري دراسة تناولت 90 سؤالًا قانونيًا باللغتين العربية والإنجليزية، مرتبطة بنظام حماية البيانات الشخصية السعودي واللائحة الأوروبية لحماية البيانات.
واختبرت الدراسة اتساق إجابات ثلاثة نماذج لغوية عند طرح الأسئلة نفسها بلغتين مختلفتين، وأظهرت النتائج اتساقًا بنسبة 87% عبر 254 زوجًا من الإجابات.
وتؤكد النتائج أهمية تقييم ثبات الإجابات القانونية عبر اللغات المختلفة، خصوصًا عند التعامل مع موضوعات تتطلب دقة في المصطلحات وفهمًا للسياقات التنظيمية.
شراكة بحثية دولية
وفي ختام المؤتمر، أعربت جامعة طيبة عن شكرها للجامعة الوطنية الماليزية على شراكتها العلمية في تنظيم الحدث، وكرّمت فرق العمل التي أسهمت في إنجاح جلساته وفعالياته.
ويعكس المؤتمر اتساع مجالات البحث في الذكاء الاصطناعي، من التطبيقات الطبية واللغوية إلى حفظ التراث والأمن السيبراني، ودور التعاون الأكاديمي الدولي في تطوير حلول بحثية قابلة للبناء عليها مستقبلًا.